紫山龙霖GalaxSphere荣登MLPerf Storage v3.0四大场景榜首之KV Cache

以下文章来源于苏州紫山龙霖信息科技有限公司,作者紫山龙霖
在MLPerf Storage v3.0 KV Cache专项测评中,测试选用Llama3.1‑8B、Llama3.1‑70B两大主流模型,紫山龙霖(国芯科技参股企业)GalaxSphere数据智能引擎,实现全模型规模下Token性能全面领先!
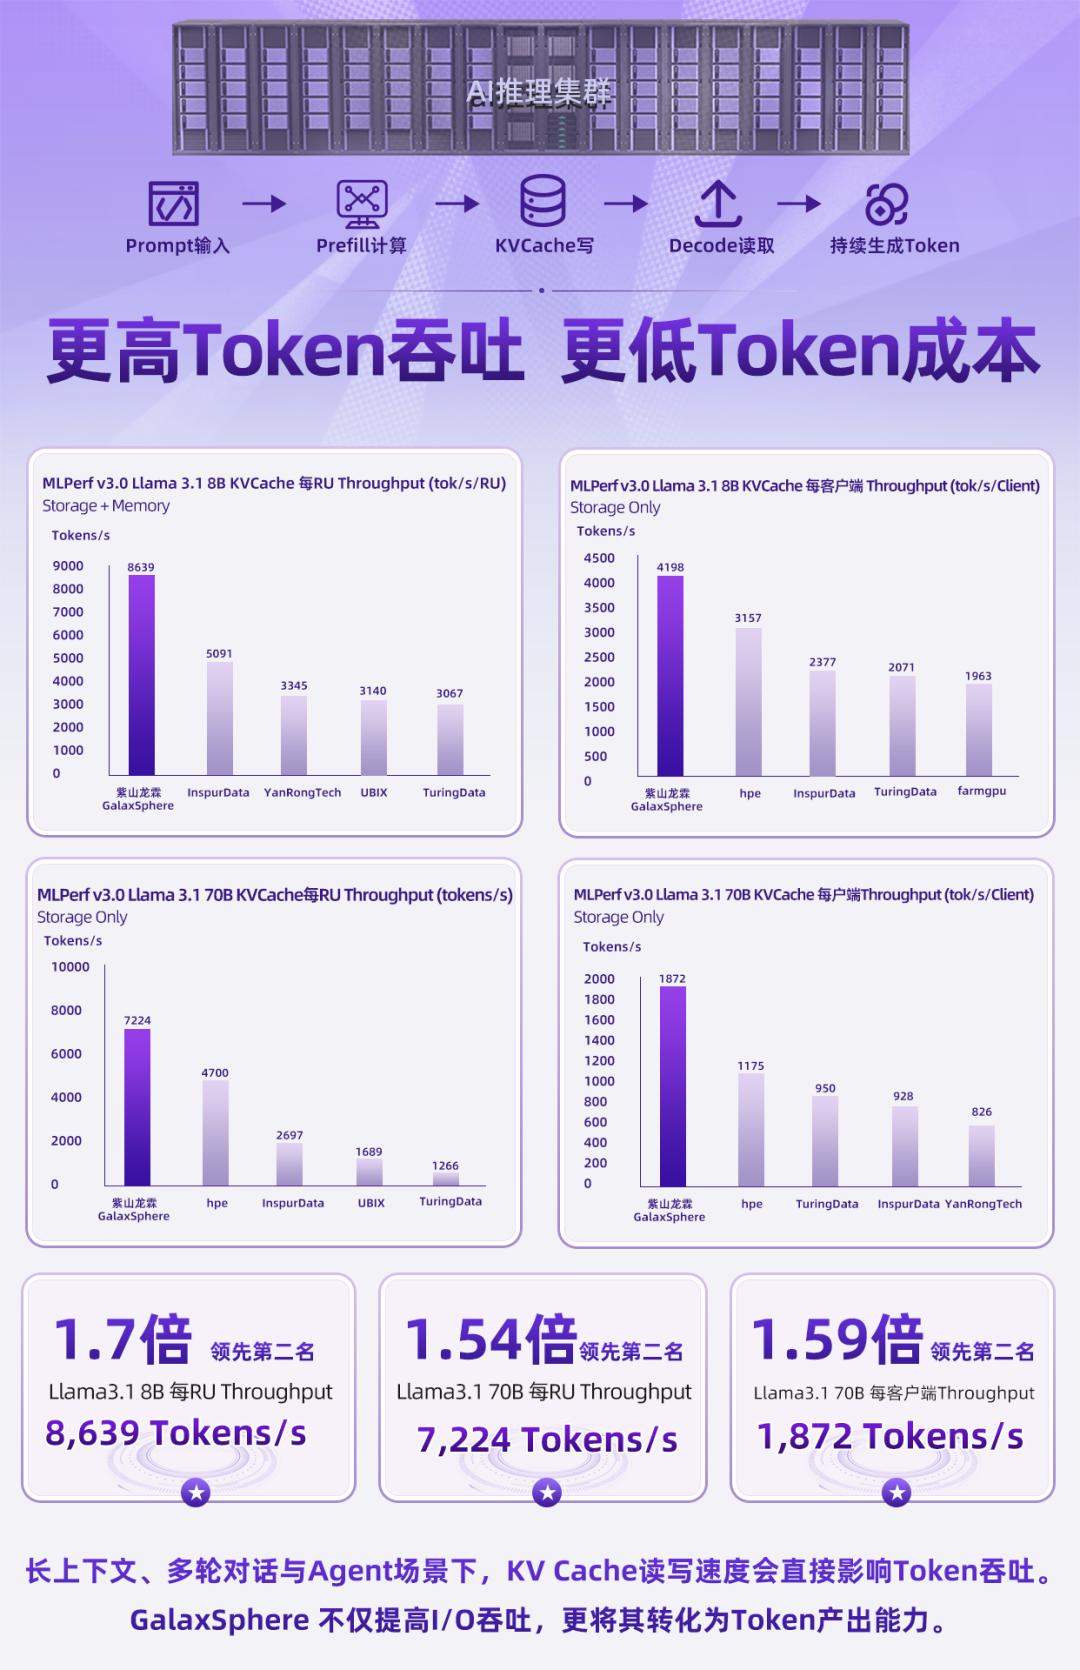
随着模型规模扩展、上下文长度增加、并发会话增多以及Agent工作流变得更复杂,KV Cache的容量和访问频率都会快速增长。推理系统面临三个突出问题:
高频读写:KV Cache需要持续加载和写回,数据路径容易成为推理链路瓶颈。
大模型与高并发:模型从8B扩展到70B,或并发请求持续增加后,对数据吞吐能力的要求同步提高。
规模扩展:GPU集群从几十张扩展到数百、数千张时,底层数据性能必须能够同步横向扩展,否则新增算力难以转化为有效Token产出。
因此,面向KV Cache的基础设施需要同时解决三个问题:单节点够快、单位机柜效率够高、集群扩展后性能还能持续增长。
将存储性能转化为Token吞吐
在MLPerfStorage v3.0 KV Cache测试中,GalaxSphere在Llama3.1-8B、70B工作负载下,Tokens/s、读带宽和写带宽均表现突出。
每客户端性能:直接提升单节点推理数据供给能力
Llama3.1-8B StorageOnly:
Throughput4,198Tokens/s,领先第二名1.33倍;
读带宽71.67GiB/s,领先第二名1.84倍;
写带宽14.38GiB/s,领先第二名1.79倍。
Llama3.1-8BStorage+Memory:
Throughput2,706Tokens/s排名第二,达到第一名的98.7%,与榜首几乎持平。
读带宽9.66 GiB/s,领先第二名1.15倍。
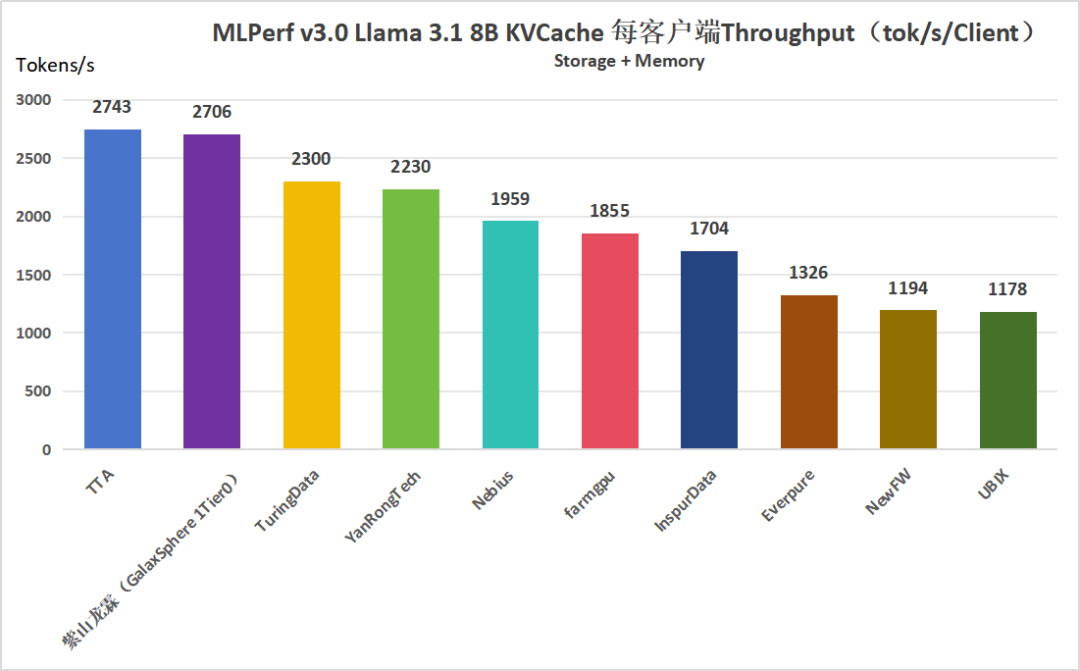
Llama3.1-8B Storage+Memory:KV Cache每客户端Throughput排名第一梯队
Llama3.1-8B Storage+Memory:KV Cache每客户端读性能排名第一
Llama3.1-70B Storage Only:
Throughput1,872 Tokens/s,领先第二名1.59倍。
读带宽77.64 GiB/s,领先第二名2.11倍。
写带宽14.85 GiB/s,领先第二名1.87倍。
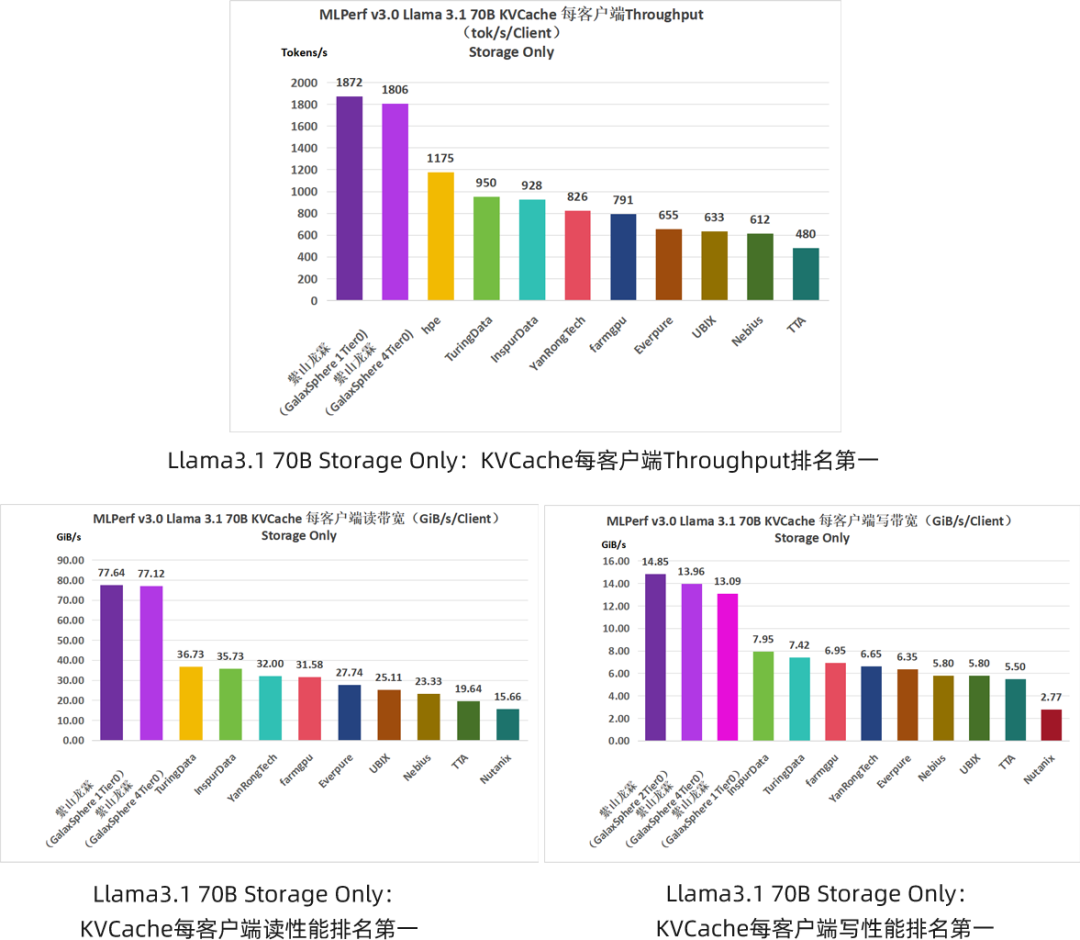
这意味着,在更大模型、更重KV Cache访问压力下,GalaxSphere依然能够保持高吞吐的数据供给能力,让推理链路减少因KV Cache读写产生的等待。
每RU性能:用更少机柜资源支撑更高Token产出
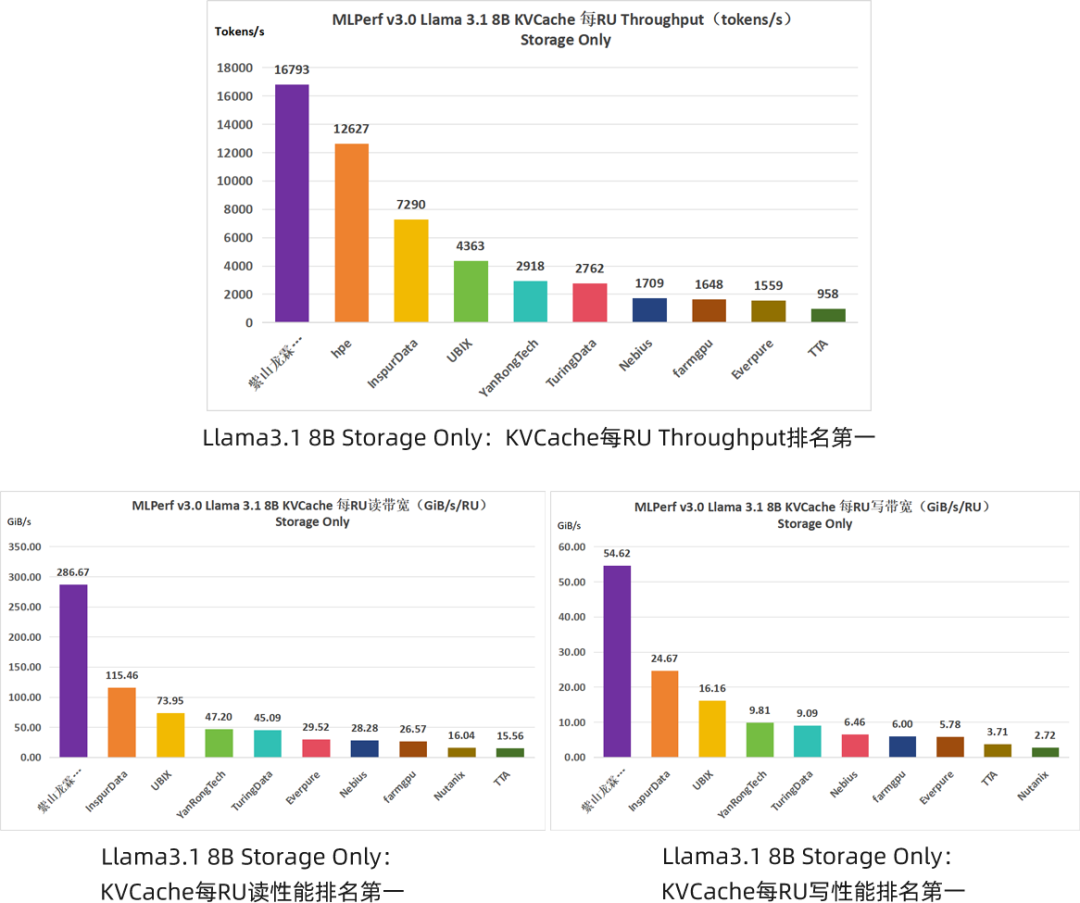
Llama3.1-8B Storage Only:
Throughput16,793Tokens/s,领先第二名1.33倍。
读带宽286.67GiB/s,领先第二名2.48倍。
写带宽54.62GiB/s,领先第二名2.21倍。
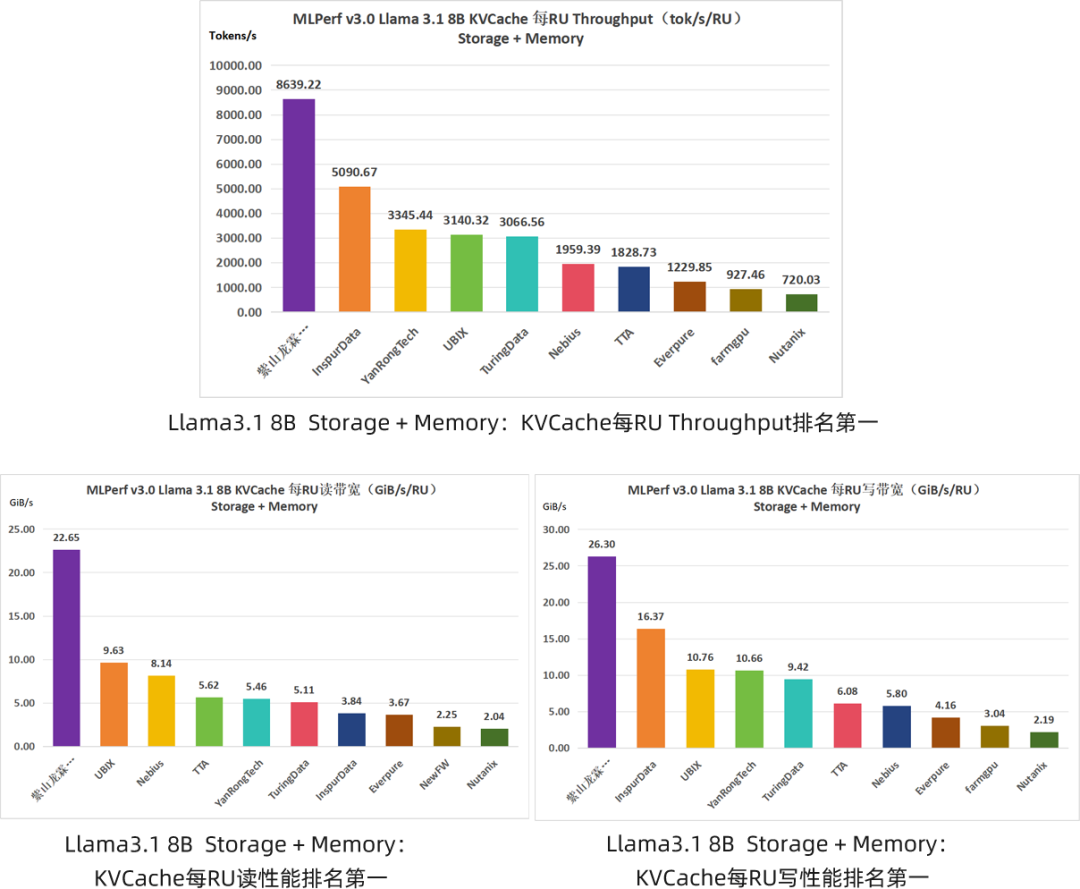
Llama3.1-8B Storage+Memory:
Throughput8,639Tokens/s,领先第二名1.7倍。
读带宽9.66GiB/s,领先第二名1.15倍。
写带宽26.3GiB/s,领先第二名1.61倍。
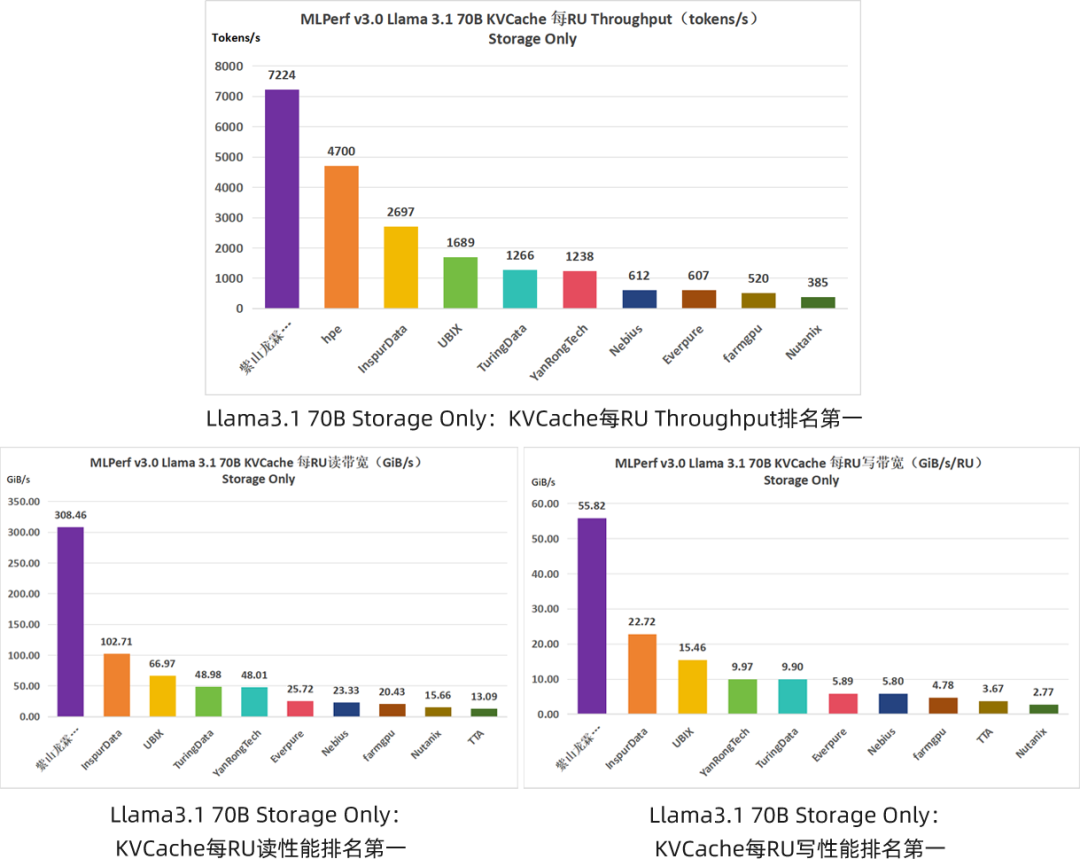
Llama3.1-70B Storage Only:
Throughput7,224Tokens/s,领先第二名1.54倍。
读带宽达到308.46GiB/s,领先第二名3倍。
写带宽达到55.82GiB/s,领先第二名2.46倍。
对于AI数据中心而言,这不仅是“跑得更快”,还意味着在有限机柜空间、电力和散热条件下,GalaxSphere可以用更高的单位基础设施效率支撑更多推理请求。
性能不是“堆出来的”,而是可以持续扩展的
KV Cache场景真正的挑战,不是一次跑出高峰值,而是当推理集群不断扩张时,数据性能能否同步增长。MLPerf Storage v3.0测试进一步验证了GalaxSphere Tier0的横向扩展能力。
本次测试分别部署1个、2个、3个、4个Tier0节点,验证不同模型参数下系统的tokens效率、并行IO能力与横向扩展能力,具体测试结果见图例:
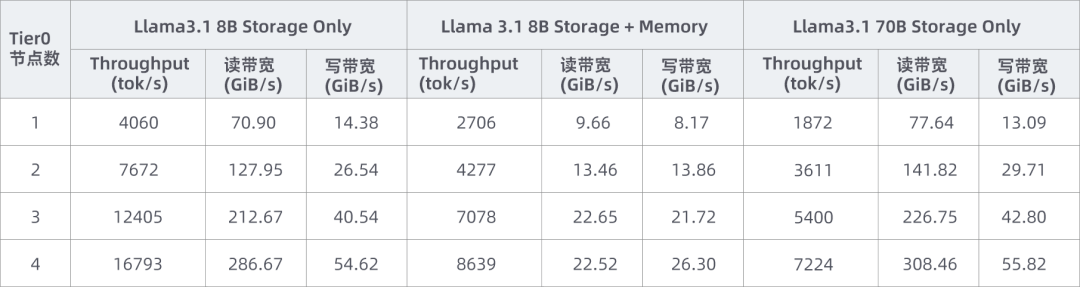
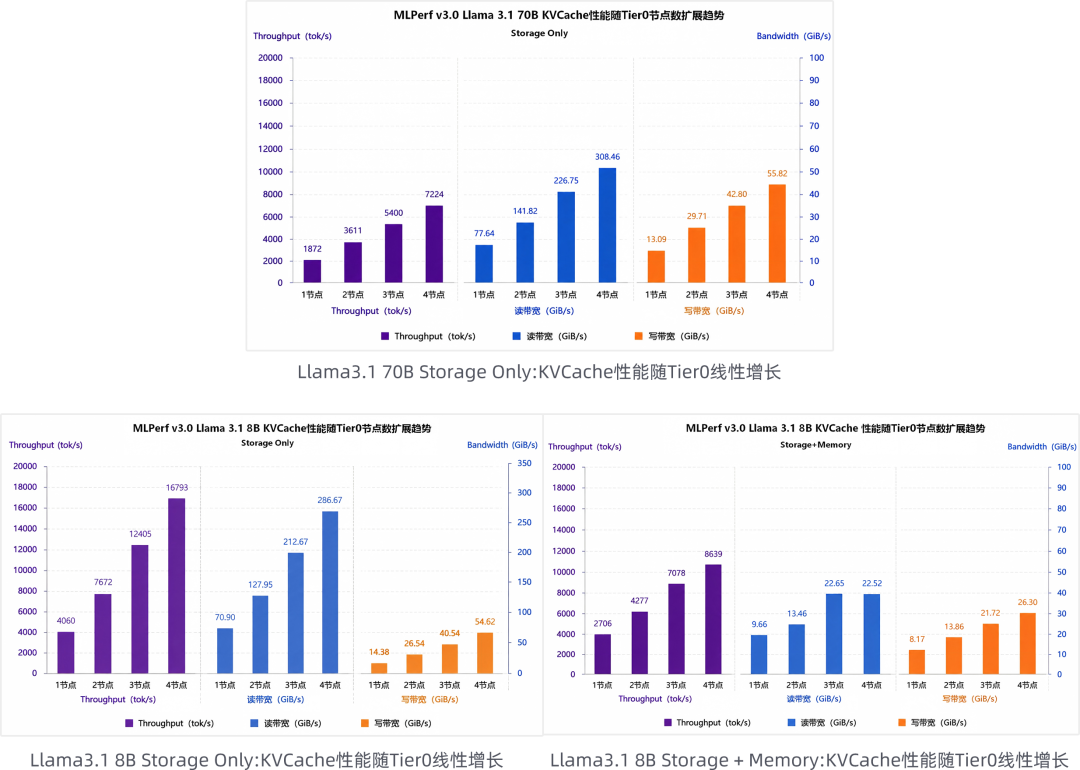
测试结果表明,GalaxSphere Tier0可以通过横向扩展持续增加KV Cache数据供给能力,使底层数据性能能够跟随推理规模增长。
方案优势:让KV Cache更高效、Token成本更低
GalaxSphere基于紫山龙霖自主研发的GLFS全局数据操作系统,通过本地NVMe Tier0、并行I/O与横向扩展,加速KV Cache读写,支撑高效复用,让数据供给效率转化为推理产出效率。
就近访问,减少GPU等待。让高频访问的KV Cache更靠近GPU,缩短数据路径,减少缓存加载等待,让昂贵算力更多用于推理计算。
并行加速,提升有效Token吞吐。提升KV Cache加载与写回效率,配合推理框架复用已计算的上下文,减少重复计算,支撑更低的首Token时延与更高的有效吞吐。
按需扩展,支撑更大规模并发。随Tier0节点增加扩展缓存容量与总体带宽,缓解数据供给瓶颈,让新增算力更充分地转化为Token产出。
GalaxSphere在满足推理时延要求的前提下,让同等算力产出更多有效Token,降低了每个有效输出Token的成本。
结语:AI推理竞争,正在从算力走向Token效率与成本
随着模型、长上下文、多轮对话和Agent应用快速发展,KV Cache将越来越成为连接存储与推理效率的关键数据层。
MLPerf Storage v3.0测试显示,GalaxSphere在8B、70B KV Cache场景中实现了领先的Tokens/s与读写性能,并验证了Tier0随节点增加持续扩展的能力。
让KV Cache读写更快、复用更高效,减少重复计算与GPU等待,让相同算力投入支撑更多有效Token产出,为大幅降低每个有效输出Token的成本提供支撑——让数据性能转化为推理效率与成本优势,正是GalaxSphere面向AI推理基础设施所要解决的核心问题。
数据来源:MLPerf Storage Results. URL:https://mlcommons.org/benchmarks/storage/
相关文章
-

泰国央行拟三项措施破解中小企业融资难题
-

国资委公布17户中央企业23名领导人员职务任免
-
医保缴费年限可按月累计 灵活就业人员参保有了新选择
-
郑钦文不敌2号种子莱巴金娜 止步美网8强
-

告别“万金油”锻造“专门家”:湖南首家辅导员学院揭牌成立
-

最高法发文规制“大数据杀熟”“仿冒名人带货”
-

中央气象台继续发布台风蓝色预警
-

秀我中国丨“赛考斯”:我的心有一部分留在了中国