如何加速Arm Neoverse平台上的分布式推理

作者:Arm 云 AI 主任软件工程师 Bolt Liu
开发者可以出于多种原因在多个系统之间部署分布式 CPU 推理。例如,运行无法容纳在单个系统中的模型、提升较小模型的推理吞吐量,或利用闲置的 CPU 服务器集群来处理离线人工智能(AI)工作负载。然而,增加更多系统并不一定会自动带来性能提升。通信开销很快就可能成为性能瓶颈,即使有额外的计算和内存资源可用,也会阻碍分布式推理实现高效扩展。
当张量并行推理扩展到多个系统时,通信开销可能会成为瓶颈。传统的扁平化 TCP All-reduce 操作可能会进一步加剧这一问题,因为每一层计算都需要在系统之间反复进行通信,导致处理过程频繁等待。基于 Arm Neoverse 平台的系统兼具大容量内存、强大的 SIMD 执行能力以及面向基础设施级工作负载的高效计算能力,非常适合纯 CPU 推理场景。
本文将探讨如何在搭载 Arm Neoverse V2 CPU 的两台 NVIDIA Grace 系统上降低这类通信开销。在 vLLM 等主流推理框架中,Gloo 是纯 CPU 推理场景下的默认通信后端,并且默认采用 TCP 通信方式。我们从一个受 TCP 通信限制的基线配置出发,并逐步引入以下三项优化:
引入分层 All-reduce(HAR)设计,将系统内通信保留在共享内存中,并借助 RDMA 仅在跨系统时进行一次网络通信。
让 Logits 集体通信(Logits Collective)也通过同样的高速通信路径进行处理。
针对解码阶段优化 OpenMP 线程行为。
这些优化共同将 Qwen2.5-14B-Instruct 在 TP=4 配置下的中位数解码吞吐量从每秒 5.47 个输出 Token(词元)提升至 40.8 个输出 Token。HAR 对于规模较小的分布式拓扑同样能够带来显著收益。在跨两台系统、采用 TP=2 的配置下,HAR 实现了每秒 34.4 个输出 Token 的吞吐量;采用 TCP 通信时,吞吐量为每秒 11.74 个输出 Token;而采用直接 RDMA 通信路径时,则达到每秒 18.68 个输出 Token。此外,由于单台 NVIDIA Grace 系统的内存容量不足,无法运行 Qwen3-235B-A22B 模型,而双系统配置成功支持了该模型运行。这些结果表明,分布式 CPU 推理不仅能够提升吞吐量,还能增强拓扑部署灵活性,并支持运行更大规模的模型。
测试环境
本次评测采用两台通过以太网互连的 NVIDIA Grace 系统。每台系统配备两个 NUMA 域、144 个 Arm Neoverse V2 核心以及 960GB LPDDR5X 内存。软件栈包括采用 CPU 后端的 vLLM、集成 Arm 计算库(Arm Compute Library, ACL)的 PyTorch、作为基线集体通信层的 Gloo,以及 Ubuntu 24.04.4 和 Linux kernel 6.8.0-124-generic。本次测试的主要模型为 BF16 精度的 Qwen2.5-14B-Instruct,张量并行度设置为 TP=4。
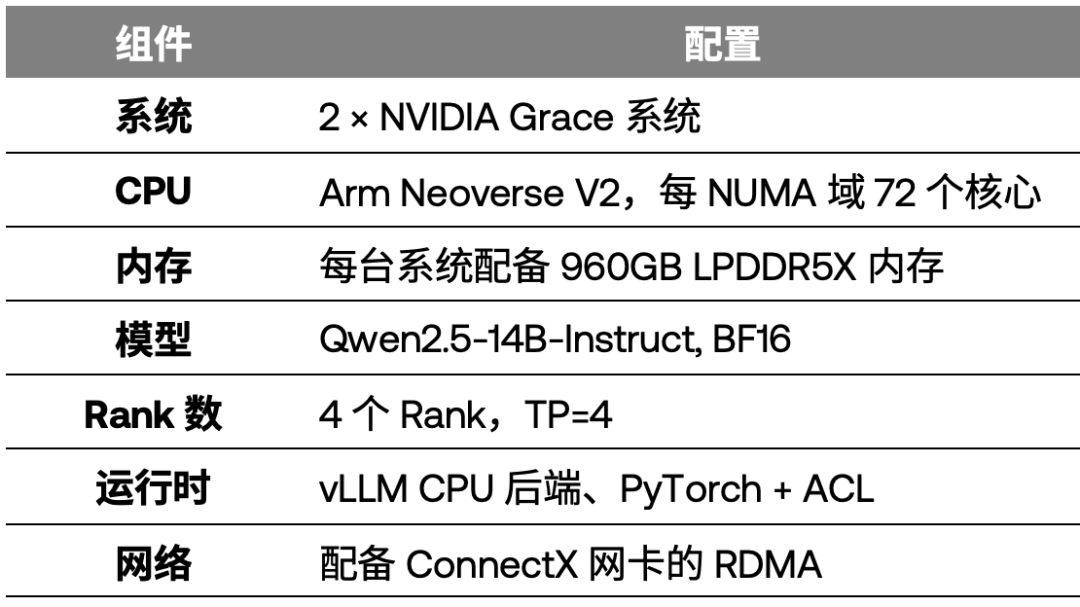
图 1:针对 TP=4 CPU 推理的双系统 Grace 拓扑结构:
系统内部采用共享内存,系统之间通过 RDMA 进行通信
基线性能瓶颈:
扁平化 TCP All-reduce
在 TP=4 配置下,每个 Rank 都会为行并行操作计算一部分结果。随后,通过一次 All-reduce 操作将这四个部分结果进行求和,并将完整的输出张量返回给所有 Rank。完成这一过程后,后续依赖该结果的计算才能继续执行。在基线方案中,Gloo 采用基于 TCP 的、与拓扑结构无关的环形 All-reduce。这种环形结构会将所有链路视为相同,但实际上,同一系统内部的通信速度远快于跨系统通信。
在采用 4 个 Rank 的情况下,环形 All-reduce 需要先执行归约分散操作,再执行全收集操作,总共需要串行完成 2(N−1),即六个步骤。在这种拓扑结构下,四条环路边中有两条跨越不同系统。因此,每一个串行步骤都需要等待通过网络进行速度较慢的 TCP 通信。Qwen2.5-14B 在每一层大约执行两次 All-reduce 操作,换算下来,每生成一个输出 Token 大约需要完成 96 次集合通信。因此,解码阶段的性能瓶颈来自网络,而非计算能力本身。
在基线测试中,系统实现了每秒 5.47 个输出 Token 的生成速度。此时,Grace 核心并非性能限制因素,解码路径主要耗时于反复进行的 TCP 网络往返通信。
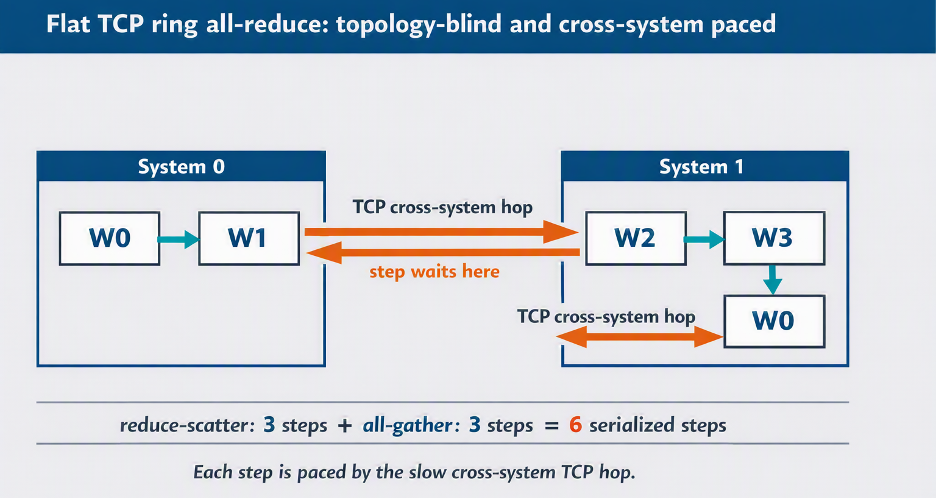
图 2:当 TP=4 时,扁平化 TCP 环形 All-reduce 需要经过六个串行步骤,每一步都需要等待一次跨系统的 TCP 跳转通信
以下为采用 TCP Gloo 与单 TP 配置运行时的性能数据对比:
HAR:让本地通信留在本地
这一方案的核心思路是依据物理层级结构拆分集合通信。系统内部通信通过共享内存完成,而跨系统通信则通过以太网进行一次 RDMA 数据交换。我们将这一设计称为 HAR。
HAR 利用 RDMA 执行通信,并在共享内存中完成最终归约。每个 Rank 通过带即时通知的 RDMA Write 操作,将自身的数据分片写入远端系统中对应的 Rank。当远端数据分片到达后,共享内存屏障会对本地各个 Rank 进行同步。随后,每个 Rank 在两个共享内存槽位之间执行最终的本地归约操作。HAR 无需依赖主节点中继,也不需要执行广播操作。每个工作进程都能够在本地独立计算最终结果。
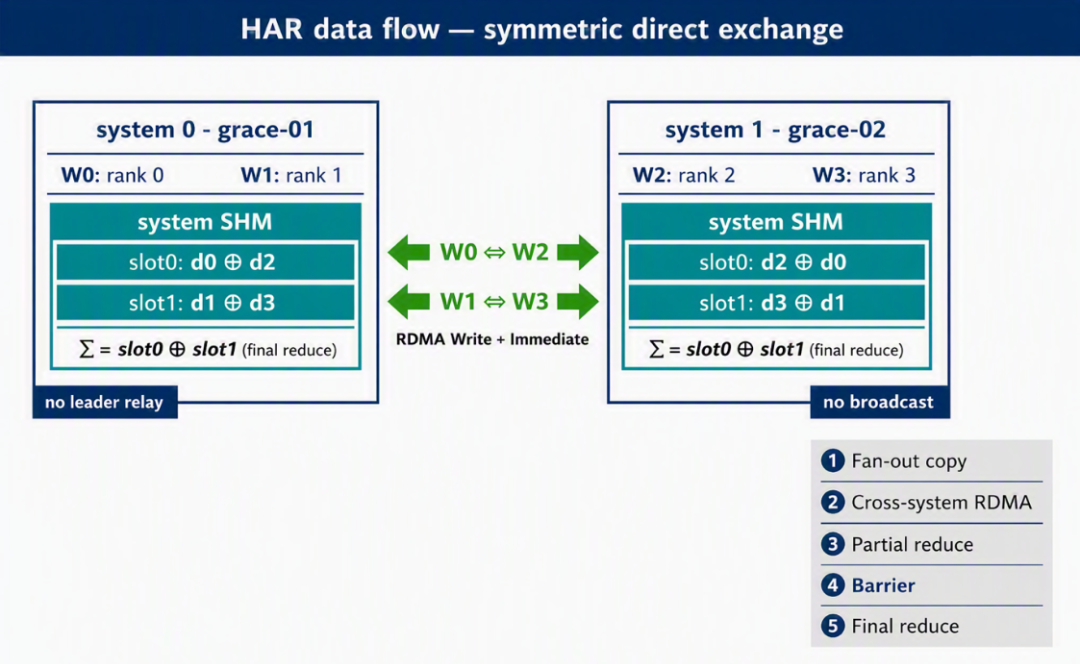
图 3:HAR 通过 RDMA 在不同系统之间交换相同 Rank 的数据分片,随后利用共享内存在本地完成最终归约
扇出复制:每个 Rank 将自身的数据分片分别写入本地共享内存槽位和 RDMA 发送缓冲区。
跨系统交换:具有相同 Rank 的节点通过 RDMA 并行交换数据分片。
部分归约:每个 Rank 将接收到的远端数据分片归约到本地槽位中。
共享内存屏障:本地节点完成同步。
最终归约:将 slot0 和 slot1 在本地求和,从而生成完整的 All-reduce 结果。
这将原先六个受 TCP 通信节奏限制的串行步骤,替换为 一次 RDMA 通信交换、轻量级共享内存同步,以及最终一次本地共享内存归约操作。首次优化后,吞吐量从每秒 5.47 个输出 Token 提升至 25.4 个,较 TCP 基线方案提升 4.6 倍。
通过高速路径传输 Logits
在 HAR 消除了隐藏状态 All-reduce 带来的主要开销后,每个 Token 的 Logits 聚合成为新的性能瓶颈。这一瓶颈实际上在原有框架中已经存在,只是在 HAR 优化之后变得更加明显。在原始实现中,Gloo 通过 TCP 套接字完成 Logits 聚合。由于在每一步解码过程中,该操作都需要传输覆盖整个词汇表的张量,因此它成为剩余的跨系统通信瓶颈。
优化后的方案会先将每个 Rank 的 Logits 分片通过零填充扩展至完整词汇表大小,然后利用 HAR all-reduce 来重构最终的 Logits。这种方式虽然比根节点聚合传输更多数据,但它用 RDMA verbs 和分层通信路径替代了内核 TCP 套接字通信。与此同时,该通信路径具备拓扑感知能力:当张量并行 Rank 分布在多个系统上时,Logits 将通过基于 RDMA 的 HAR 路径完成通信;当所有 Rank 均位于同一系统内时,则继续使用原有的共享内存通信路径。
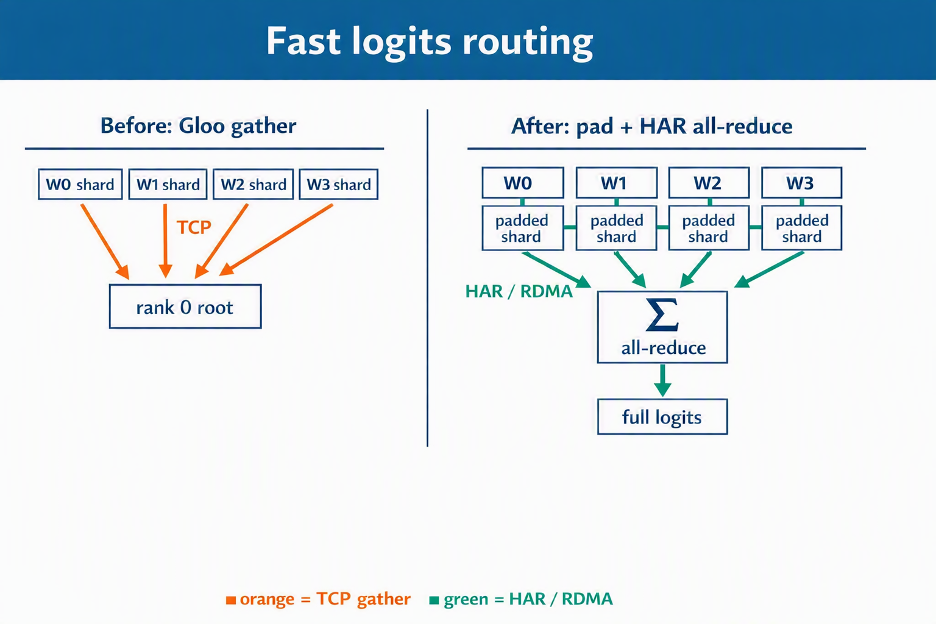
图 4:当张量并行 Rank 跨多个系统部署时,高速 Logits 路由通过基于 RDMA 的拓扑感知 HAR All-reduce,取代了基于 Gloo/TCP 的根节点聚合
通过 HAR 路由 Logits 后,吞吐量从每秒 25.4 个输出 Token 提升至 36.2 个,在 RDMA HAR 带来的性能提升基础上,又进一步提高了 42%。
让 OpenMP 线程在解码过程中保持活跃
随着网络通信瓶颈得到缓解,CPU 侧调度开销成为新的性能瓶颈。解码过程包含大量短时间运行的并行区域,例如归一化、QKV 投影、注意力以及多层感知机(MLP)运算。如果 OpenMP 工作线程在这些短任务之间进入休眠状态,那么下一个计算阶段就需要承担 futex 唤醒、操作系统调度以及缓存预热等额外开销。
通过将 GOMP_SPINCOUNT 设置为 100M,空闲的 OpenMP 工作线程将保持自旋状态,而不是进入休眠。在专用且经过绑定的 CPU 核心上,这些 CPU 周期原本处于空闲状态,因此对于受延迟限制的解码场景而言,这种权衡更具优势。
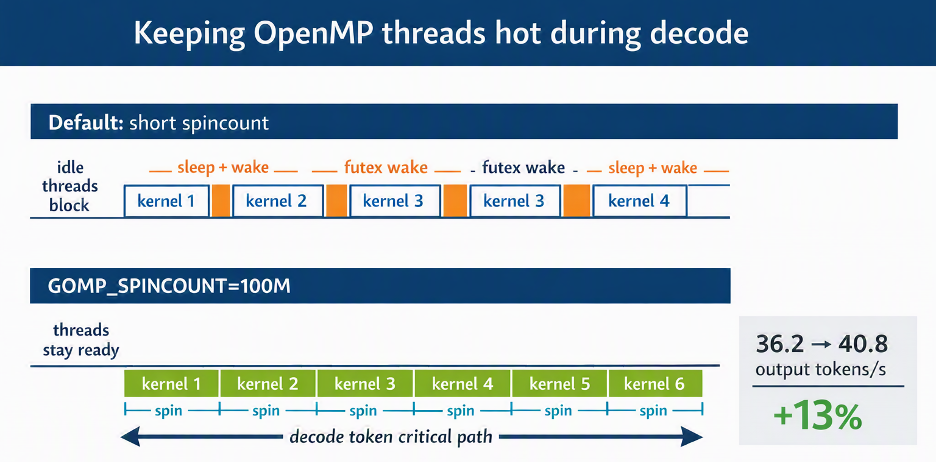
图 5:提高 GOMP_SPINCOUNT 参数后,OpenMP 工作线程能够在多个短时解码内核之间保持就绪状态,从而减少关键路径上的线程唤醒开销
注意:该优化最适用于预留核心环境。在共享资源或过度分配的系统中,忙等待可能会增加功耗,并影响其他工作负载。
测试结果
完整的优化路径展示了每一步如何消除解码过程中的不同瓶颈。最终配置实现了每秒 40.8 个输出 Token 的吞吐量,相较于 TCP Gloo 基线方案提升了 7.45 倍。
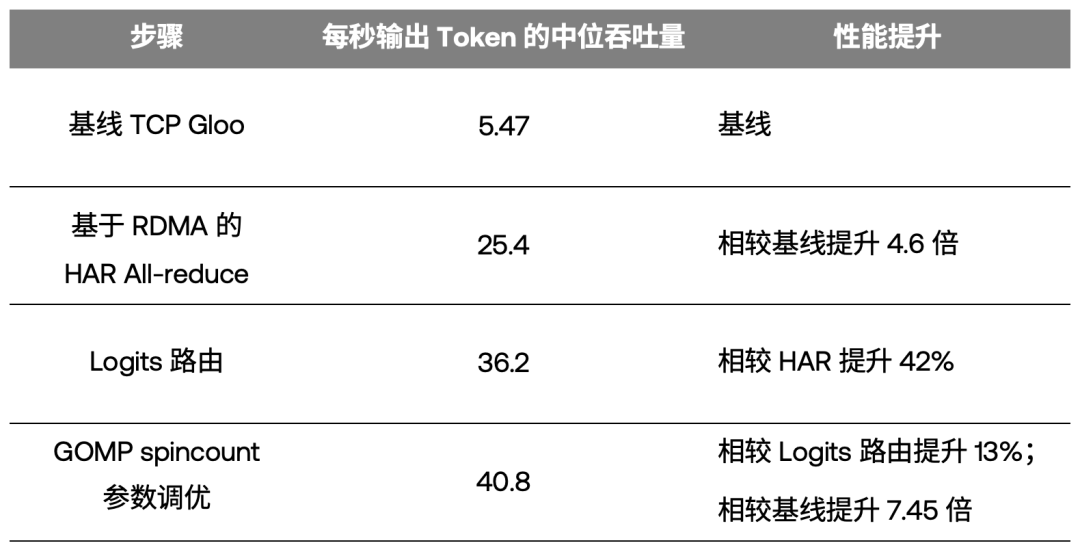
从不同拓扑结构的对比结果来看,采用 HAR 和线程优化后的 TP=4 配置,其性能已经超过单系统共享内存模式下的 TP=2 配置。优化后的 TP=4 实现了每秒 40.8 个输出 Token,而单系统 TP=2 共享内存配置的吞吐量为每秒 32.49 个,提升幅度达到 26%。这一结果表明,只要通信路径能够感知底层拓扑结构,分布式推理不仅能够扩展内存容量,还能够获得更高的吞吐量。
HAR 同样适用于 TP=2
HAR 优化并不仅限于 TP=4 场景。在跨两台系统的 TP=2 配置中,每台 NVIDIA Grace 系统仅运行一个 Rank,因此拓扑结构更加简单。在这种情况下,系统内部不存在需要先进行归约的本地 Rank 对,因此 HAR 会退化为一种精简的双向 RDMA verbs All-reduce 实现。即便如此,该方案依然能够避开 TCP 套接字通信路径,使分布式集体通信始终运行在低延迟 RDMA 网络之上。
TP=2 的测试结果与 TP=4 呈现出相同趋势。是否采用拓扑感知通信机制,决定了增加第二台系统后能否同步获得性能提升。结果显示,TCP 跨系统配置达到每秒 11.74 个输出 Token,直接 RDMA 通信路径提升至每秒 18.68 个输出 Token,HAR 为每秒 34.4 个输出 Token。HAR 的性能甚至略高于单系统 TP=2 共享内存配置的每秒 32.49 个输出 Token。
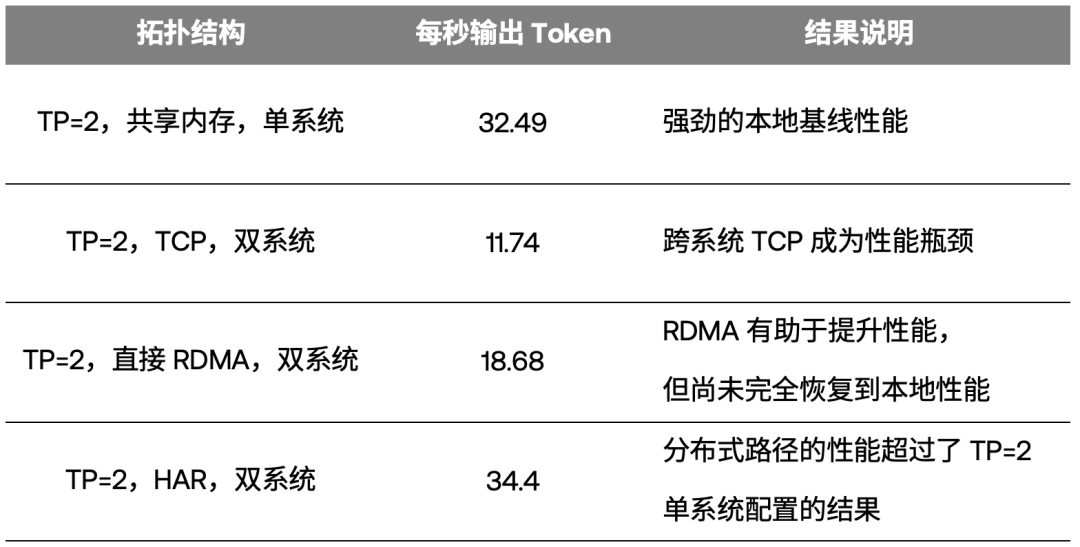
这一结果意义重大,因为当模型或工作负载无法容纳于单台系统时,TP=2 往往是开发者尝试的首个分布式部署方案。HAR 让这一步骤真正具备实际价值,使用户在获得分布式扩展能力的同时,不会让跨系统通信成为主要成本。
扩展至更大规模模型
同样的分布式架构还支持在两台 NVIDIA Grace 系统上,以 TP=4 运行 Qwen3-235B-A22B。由于内存不足,单台 Grace 系统无法加载该模型。而采用双系统配置后,在包含 10 个提示词的 ShareGPT 基准测试中,实现了每秒 4.21 个输出 Token 的吞吐量。
前文的性能分析主要围绕 Qwen2.5-14B-Instruct 展开,因为该模型能够更直观地对比不同通信路径,并量化每项优化措施带来的效果。然而,分布式推理的价值不仅体现在性能提升方面,还有另一项重要优势,即支持运行无法部署在单台系统中的大规模模型。
Qwen3-235B-A22B 正是这一优势的典型案例。虽然单台 Grace 系统因内存耗尽而无法完成推理,但通过 TP=4 将模型分布式部署到两台 Grace 系统后,推理得以顺利运行,并在包含 10 个提示词的 ShareGPT 基准测试中达到每秒 4.21 个输出 Token。这证明基于 Arm Neoverse 平台的多系统部署不仅能够支持更大规模模型,同时仍能够保持具有实用价值的 CPU 推理性能。
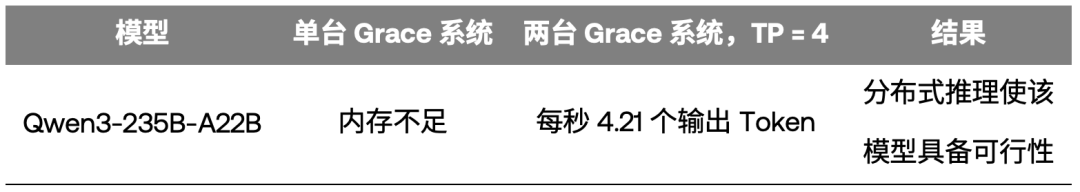
这一结果进一步凸显了拓扑感知分布式推理的价值。通信优化能够显著提升延迟和吞吐量,而跨系统的内存聚合则使部署规模远超单台系统所能支持的上限。
上游贡献
HAR 实现已作为可选功能提交 PR[1]至 vLLM 社区。系统通过 VLLM_CPU_RDMA_HAR CMake 缓存变量控制 RDMA 通信路径。默认情况下,该选项为 OFF,因此不会改变标准 CPU 构建方式,也避免在不支持 RDMA 的系统中引入 libibverbs 依赖。
启用 HAR 后,构建过程将链接 libibverbs、编译 RDMA 相关操作,并注册 CPU RDMA 集体通信实现。
禁用 HAR 后,所有 RDMA 相关符号都会从编译结果中移除,CPU 通信路径与上游共享内存实现完全一致。
本次贡献新增了面向多节点张量并行的分层 All-reduce 机制,以及拓扑感知的 Logits 路由能力。
[1] https://github.com/vllm-project/vllm/pull/46447
关键结论
拓扑结构至关重要。扁平化环形 All-reduce 会让分布式解码持续等待跨系统 TCP 通信。
基于 RDMA 的 HAR 消除了主要瓶颈。 系统内部通信由共享内存完成,而系统间通信仅需一次 RDMA 数据交换。
瓶颈会动态转移。当隐藏状态集体通信迁移至 RDMA 后,Logits 聚合和 CPU 调度开销成为新的限制因素。
分布式 CPU 推理能够超越单系统性能。跨两台 Grace 系统部署的 TP=4 配置实现了每秒 40.8 个输出 Token,超过单系统 TP=2 共享内存配置的性能表现。
分布式扩展支持更大模型。两台 Grace 系统成功运行了 Qwen3-235B-A22B,而单台系统则因内存不足无法运行。
结论
在 Arm Neoverse 平台上实现高效分布式推理,并不仅仅意味着增加更多系统节点,还需要采用与硬件拓扑结构相匹配的通信算法。经过优化后,系统使用分层 RDMA 架构替代了与拓扑无关的 TCP All-reduce机制,并通过高速路径处理 Logits,同时让 CPU 工作线程始终保持就绪状态,以满足低延迟解码需求。这些优化共同带来了 7.45 倍的实测吞吐量提升。与此同时,该方案对于 TP=2 等较小规模分布式拓扑同样有效。HAR 不仅超过了单系统 TP=2 共享内存配置的性能表现,还显著提升了模型容量。例如,Qwen3-235B-A22B 能够以 TP=4 方式运行于两台 Grace 系统,而单台 Grace 系统则会因内存耗尽而无法运行。
总体而言,这一方案为基于 Arm Neoverse 平台的大语言模型(LLM)纯 CPU 分布式推理提供了一条切实可行的扩展路径。同时,通过构建阶段的可选配置设计,也确保了对上游社区用户的良好兼容性与可移植性。
* 本文为 Arm 原创文章,转载请留言联系获得授权并注明出处。
相关文章
-
AMD Ross深度解读:自然语言正在成为嵌入式开发的“下一种设计语言”
-
力合微×智有范,以PLCP-Matter打造苹果生态稳定全屋智能
-
2.69亿!硅片涨价潮下国产龙头再增持!
-
PCB设计外包公司怎么选?看这4个硬标准
-
测控信号调理链路是什么
-
AMD Vitis™ IDE接入DeepSeek和Qwen:开启Agentic AI辅助开发之旅
-
PLC与变频器的结合使用注意事项
-
激光焊接技术在焊接逆变器散热器中的工艺