后摩智能漫界M50芯片完成面壁智能MiniCPM-V 4.7大模型适配

10月13日,面壁智能联合OpenBMB社区正式发布并开源端侧多模态大模型系列最新作MiniCPM-V 4.7。作为面壁智能的紧密合作伙伴,后摩智能同步完成MiniCPM-V 4.7在后摩漫界M50芯片上的深度适配,并将端侧MoE多模态大模型的适配时效性推到Day 0。
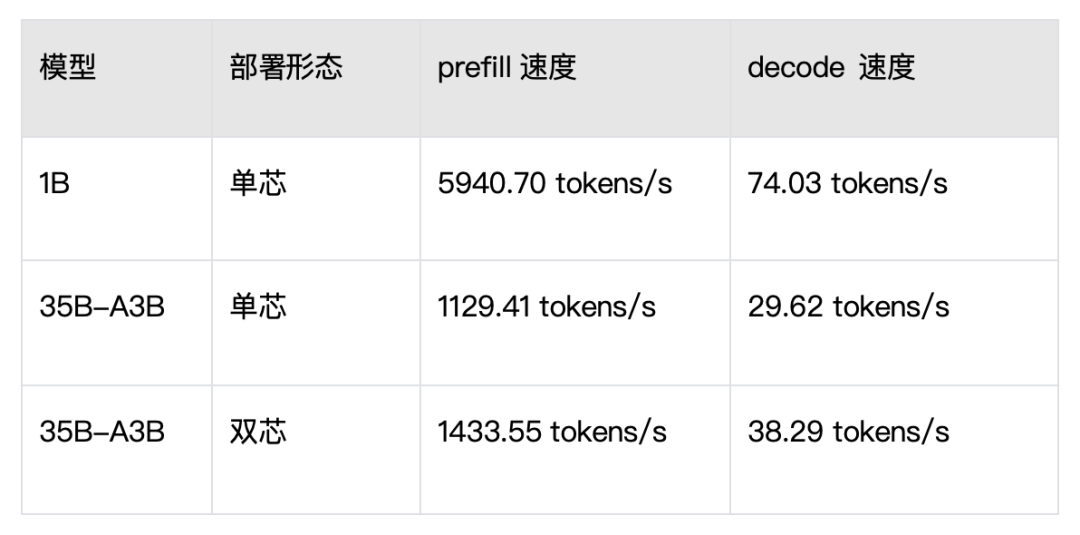
开发者通过后摩大道工具链,可在M50上完成从量化编译到推理部署的全流程闭环,将MiniCPM-V 4.7以单颗M50或双M50的形态运行于端侧设备。
在内存与算力均受严苛约束的端侧场景中,模型必须在有限开销内释放尽可能强的能力——这种对「能力密度」的极致追求,与后摩智能「高能效比」的技术理念不谋而合。
MiniCPM-V 4.7以35B-A3B和1B两个版本,同时刷新了多模态大模型的「性能—效率帕」:
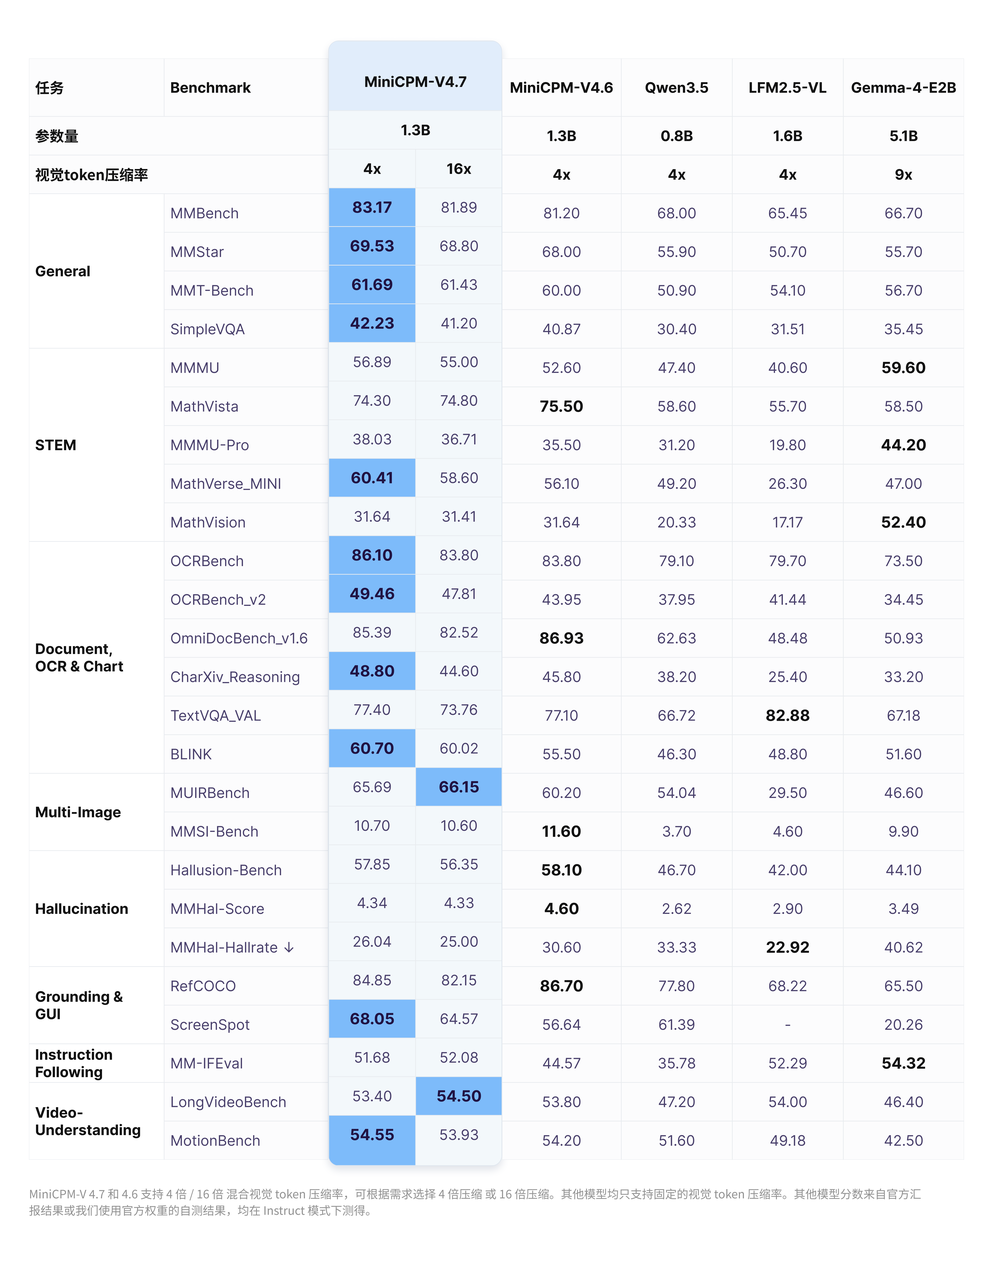
35B-A3B:在Instruct模式下,以更短的推理时间取得了比Qwen3.6-35B-A3B更高的综合得分。
1B:在MiniCPM-V 4.6的基础上持续升级,得分和推理效率均显著领先 Qwen3.5-0.8B。
35B-A3B旗舰版:端侧多模态能力新上限
在34项权威基准测评中,MiniCPM-V 4.7 35B-A3B在通用视觉(MMBench 91.72、MMStar 80.67)、STEM(MMMU 80.22、MathVista 88、MathVerse 86.45)、OCR/图表(OCRBench 91.2、CharXiv Reasoning 75.6)和长视频(LongVideoBench 68.9)等核心多模态任务上全面领先同档的Qwen3.6-35B-A3B,甚至超越了更大体量的Qwen 27B、Gemma-4 31B,看图、读文档、做题、看视频,样样精通。
1B小钢炮:轻量级设备的极致效能
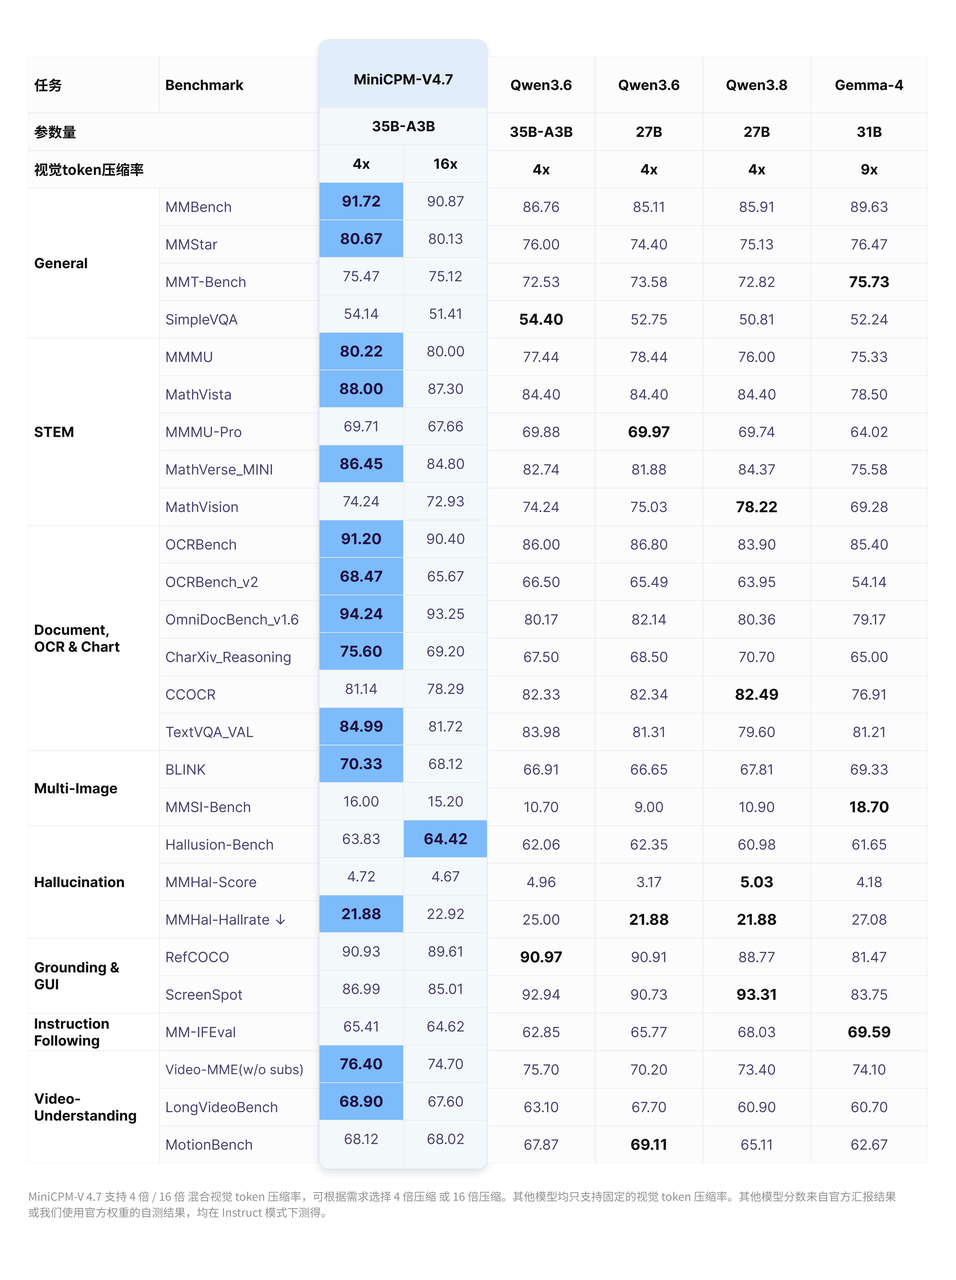
1B版本以极小体量达到同尺寸性能第一梯队,专为广泛的移动终端普惠而生。与同档的Qwen3.5-0.8B,乃至体量更大的LFM2.5-VL 1.6B/3B相比,它在通用视觉、OCR、图表推理、多图理解上全面占优。
兼顾「轻盈体量」与「高效智能」,MiniCPM-V 4.7 1B可以在入门级端侧设备上无压力流畅运行,让多模态能力覆盖更多日常设备与使用场景。
端侧AI长期面临一个根本矛盾:模型参数规模持续增长,而终端设备的物理约束几乎不变。M50基于存算一体架构的第二代SRAM-CIM双端口设计,权重加载与矩阵计算并行执行,数据就近处理,显著削减存储与计算单元之间的搬运开销。芯片提供 160TOPS@INT8与 100TFLOPS@bFP16算力,内存带宽153.6 GB/s,最高支持48GB LPDDR5/5X,典型功耗10W;片间通过HM-Link以16 GB/s互联,算力或容量不足时可扩展至双芯片协同。
在这样的算力与带宽条件下,35B-A3B这类超出设备内存的模型,经量化压缩与双芯内存扩展,可以完整装入端侧本地运行,不必依赖云端。M50正打破端侧AI长期难以兼顾的性能、功耗与成本「不可能三角」。
与硬件能力同样重要的是响应速度。新模型权重发布当天,后摩即完成在M50上的适配,开发者无需再等待以周或月计的芯片适配周期——模型开源与端侧可用之间,不再有时差。
Day 0 背后的技术底座
Day 0并非自动达成。一个新模型从权重发布到在芯片上稳定运行,需要跨越算子支持、图编译、精度校验、性能调优四重关口;多模态模型还额外涉及视觉与语言链路的拼接。能够在发布当天完成全部环节,依靠的是一套成熟的工具链,以及一支经验丰富的团队。
后摩大道工具链以模型架构为单位沉淀公共能力,而非针对单个模型做定制开发。注意力、MoE路由、归一化、视觉编码器等通用结构已在工具链中沉淀为可复用能力,新模型带来的是结构层面的变化,而非从头重写部署流程。工具链支持PyTorch等主流训练框架的模型导入,编译产物可经llama.cpp、Ollama、vLLM、SGLang等推理引擎封装为标准化API服务。
工具链全流程:从权重到部署
部署按照后摩大道工具链覆盖了从模型量化到编译再到推理服务的全链路。以下是MiniCPM-V 4.7在M50上的完整部署流程。
1.资源下载。从后摩开发者社区获取工具链资源包,从面壁智能官方仓库或HuggingFace / ModelScope获取MiniCPM-V 4.7模型权重。
2.量化导出。后摩采用GPTQ后训练量化方案,核心流程为逐层替代:每次只加载一层到GPU,用校准数据跑前向收集激活值分布,再基于Hessian矩阵将FP16权重压缩为低比特,最小化量化误差。
pythonptq.py --config config.yaml --modelHMONNX导出阶段将量化后的权重加载到ONNX计算图。导出后自动跑余弦相似度校验,对比PyTorch原始输出与HMONNX输出,确保精度无偏差。/MiniCPM-V-4.7-35B-A3B/
3.编译。编译阶段将HMONNX图转化为M50可执行的HMM文件:
pythonbuild.py --model_dir output/xh2/hmquant --model_name minicpm-v-4.7-35b-a3b --ncore2 --context_length32768 --prefill_length256 --stage build --ndevice2
参数说明:
--ncore 2:芯片运行时使用的计算核心数
--context_length 32768:最大上下文窗口,编译时设32K以优化编译速度,M50实际可支持更大窗口
--prefill_length 256:prefill阶段每次分块处理的token数
--ndevice 2:双芯片部署,单芯片指定 1
--stage build:仅编译,确认通过后可追加 --stage test 跑余弦相似度验证
4.推理测试。编译完成后在M50设备上进行推理测试,输入图像与问题,验证视觉编码与语言生成两段的端到端输出:
pythondemo.py --image_path ./demo.jpg --question"介绍下这张图片"
5.通过llama.cpp部署推理服务。工具链支持将编译产物转换为GGUF格式,通过llama-server部署为生产推理服务:
python ./scripts/convert_hm_to_gguf.py /MiniCPM-V 4.7是多模态模型,启动llama-server时需同时加载mmproj视觉投影文件。部署完成后可通过OpenAI兼容API接入Agent框架,实现从模型推理到业务落地的完整闭环。--use-temp-file ./bin/llama-server -m ./scripts/minicpm-v-4.7-35b-a3b.gguf --mmproj ./scripts/minicpm-v-4.7-mmproj.gguf
相关文章
-

博尔森磁致伸缩位移传感器卸船机料斗门液压推杆应用
-
【实操教程】集特 GM9-5601 国产工控主板(海光 3350)openEuler22.03 安装 RTX4060Ti 显卡驱动
-
【新品发布】性能全面迭代:艾为电子推出AWA87396FCR/AWA87397FCR 智能K类音频功放
-
数字电源为什么一般用DSP控制,而不能用普通的单片机
-
纳祥科技再突破:NX1227多通道DAC动态范围提升至106dB,软硬件兼容替代CS4361
-
高速数字化仪采样率如何影响信号采集保真度?
-
多协议设备池化管理:以太网温湿度采集系统的设计与实现
-
基于极海G32F031/G32M3101 MCU的无感方波暴力风扇参考方案